大语言模型:泡沫退潮后,产业落地的真问题
去年春天ChatGPT刷屏的时候,我在聚会上碰到一个开连锁火锅店的老板,拉着我问了半小时:能不能弄个大模型帮我写锅底配方,帮我管供应链?那时候我就觉得,这阵风,吹得已经超出科技圈了。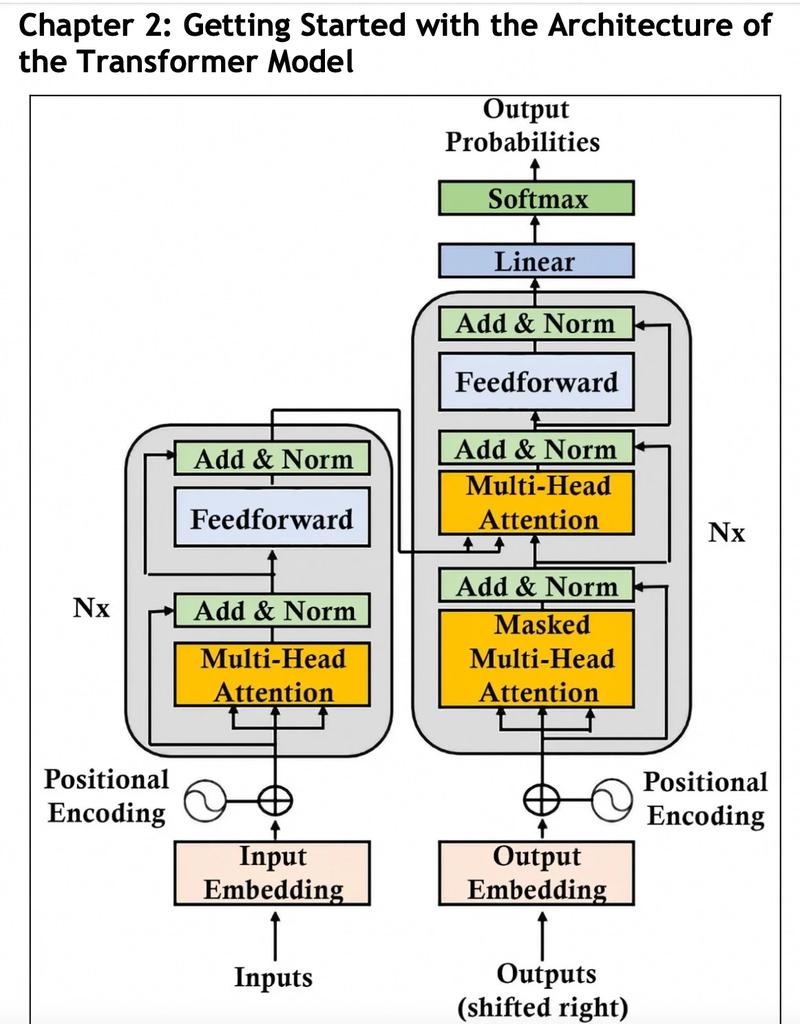 大语言模型Transformer核心架构示意图
这个核心逻辑,就决定了它天生带缺陷。幻觉就是绕不开的坎。我上个月帮一个创业朋友看融资BP,他让大模型写的行业分析部分,随手一查就发现三个不存在的行业统计数据,连调研机构名字都是编的。你说坑不坑?很多人吹大模型已经达到人类智能水平,那都是瞎吹,现在连最顶级的GPT-4,做小学数学题都会错,更别说复杂的多步逻辑推理了。这就是技术边界,短时间内破不了。
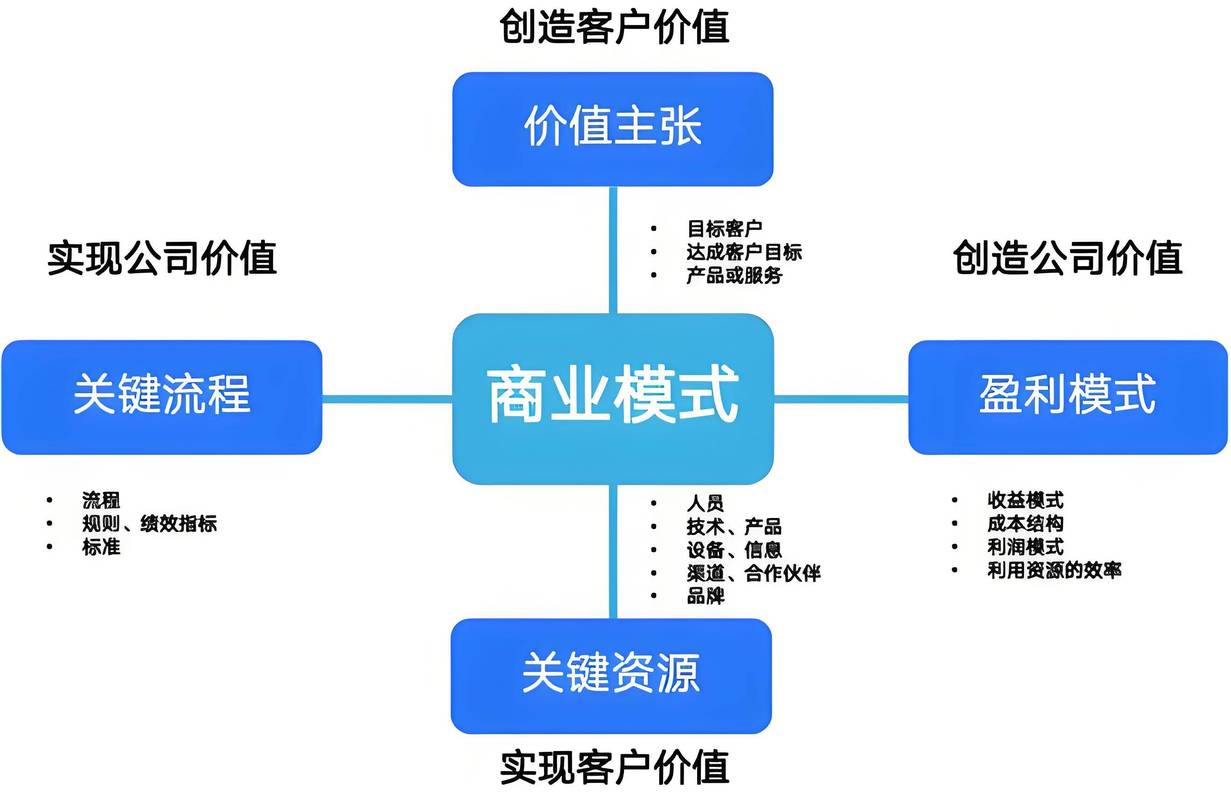 大语言模型垂直行业落地商业模式图
不过落地的障碍也真不少。第一关是数据安全。绝大多数企业不敢把自己的核心业务数据传到公有云大模型上去,万一泄露了,那就是灭顶之灾。所以现在私有部署、本地微调的需求涨得特别快,但成本又上去了。第二关是使用成本,看起来调用一次大模型只要几分钱,一天几万次调用下来,一个月就是几万块,中小商家根本扛不住。第三关是人的问题,很多企业赶风口上了AI工具,结果员工要么过度依赖,AI说什么就是什么,错了也不改,要么就是完全排斥,觉得AI要抢自己饭碗,干脆不用。说白了,很多企业现在上大模型,就是为了给PPT加个概念,根本没想清楚到底要解决什么具体问题。
 未来三年:剩下的才是真的
首先绕不开的是治理和合规的问题。现在大模型训练用了那么多有版权的内容,算不算侵权?生成出来的内容版权归谁?这些问题到现在都没有明确的规则。欧美已经有好几起影响很大的版权官司了,未来三五年,全球都会出台明确的监管规则,到时候一大批没有合规训练数据的模型公司,直接就出局了。还有深度伪造、有害内容生成这些问题,监管只会越来越严,不会放松。
我对未来三年的判断,其实很清晰。第一,全球通用大模型最后只会剩下三五家。投入太大了,要拼算力,拼数据,拼持续迭代速度,没个千亿级的投入根本玩不起,不可能养活几十上百家通用大模型,大部分都会被收购或者直接倒闭。第二,垂直场景的“小而准”模型会成真正的主流。不需要千亿参数,只要在某个细分领域足够准,能解决具体问题,就能活下去赚钱。比如给煤矿整理安全巡检记录的,给医院整理门诊病历的,给装修公司自动生成报价单的,这些场景不需要大模型懂怎么写诗,只要把一件事做好,就够了。第三,大语言模型会变成水电一样的基础设施。三五年之后,没人会天天把“大语言模型”挂在嘴边吹了,它会藏在你用的每一个软件背后:你写邮件它帮你顺一遍逻辑,你做报表它帮你整理异常数据,你做设计它帮你出素材草稿,就像你现在用电一样,你不会天天说你在用电力,你只会用它安安稳稳干活。
前阵子跟一个大厂的AI实验室负责人吃饭,他说一句话我印象特别深:当年互联网出来的时候,所有人都喊着颠覆一切,结果呢,真的改变了世界,但不是一夜之间变的,是用了二十年一点点渗进去的。大语言模型也一样。现在泡沫挤得差不多了,正好停下来,找找真问题,做做真事情。
被误解的“大”:大语言模型的真实边界
很多人说起大语言模型,第一反应就是“AI无所不能”,能写代码能写诗,还能跟你吵架。其实扒开底子看,核心逻辑特别简单:它只是在海量语料里,找下一个词出现的最高概率。它不会“理解”,更不会“真正思考”,所有输出都是概率拼接的结果。大语言模型Transformer核心架构示意图
这个核心逻辑,就决定了它天生带缺陷。幻觉就是绕不开的坎。我上个月帮一个创业朋友看融资BP,他让大模型写的行业分析部分,随手一查就发现三个不存在的行业统计数据,连调研机构名字都是编的。你说坑不坑?很多人吹大模型已经达到人类智能水平,那都是瞎吹,现在连最顶级的GPT-4,做小学数学题都会错,更别说复杂的多步逻辑推理了。这就是技术边界,短时间内破不了。泡沫退潮:产业落地的真问题
2023年一年,国内光名字带“大模型”的创业公司,就出来了上百家,融资额加起来几百亿。现在呢?一半以上已经停更了,剩下的还在找活下去的路子。说实话,一开始大家都走错路了:都抢着做通用大模型,都比参数大小,仿佛参数堆得越大,越能赢。结果呢?训一个千亿参数模型,一次就要烧上亿的电费和算力钱,中小公司烧完一轮融资,根本撑不到盈利。 现在风向变了。大家都回过神来了:通用大模型是少数巨头玩的游戏,轮不到中小公司掺合。真正能落地赚钱的,都是垂直场景。我上个月接触过一个给律所做AI工具的团队,他们根本没从头做通用大模型,就是拿大厂的开源base模型,用几十万份公开判决书做了微调,专门做判例检索和争议焦点整理。原来一个资深律师要花两三天才能干完的活,现在半小时出初稿,误差率控制在可以接受的范围,就这一个功能,一年卖几十万的服务费,客户排着队签。大语言模型垂直行业落地商业模式图
不过落地的障碍也真不少。第一关是数据安全。绝大多数企业不敢把自己的核心业务数据传到公有云大模型上去,万一泄露了,那就是灭顶之灾。所以现在私有部署、本地微调的需求涨得特别快,但成本又上去了。第二关是使用成本,看起来调用一次大模型只要几分钱,一天几万次调用下来,一个月就是几万块,中小商家根本扛不住。第三关是人的问题,很多企业赶风口上了AI工具,结果员工要么过度依赖,AI说什么就是什么,错了也不改,要么就是完全排斥,觉得AI要抢自己饭碗,干脆不用。说白了,很多企业现在上大模型,就是为了给PPT加个概念,根本没想清楚到底要解决什么具体问题。未来三年:剩下的才是真的
未来三年:剩下的才是真的
首先绕不开的是治理和合规的问题。现在大模型训练用了那么多有版权的内容,算不算侵权?生成出来的内容版权归谁?这些问题到现在都没有明确的规则。欧美已经有好几起影响很大的版权官司了,未来三五年,全球都会出台明确的监管规则,到时候一大批没有合规训练数据的模型公司,直接就出局了。还有深度伪造、有害内容生成这些问题,监管只会越来越严,不会放松。
我对未来三年的判断,其实很清晰。第一,全球通用大模型最后只会剩下三五家。投入太大了,要拼算力,拼数据,拼持续迭代速度,没个千亿级的投入根本玩不起,不可能养活几十上百家通用大模型,大部分都会被收购或者直接倒闭。第二,垂直场景的“小而准”模型会成真正的主流。不需要千亿参数,只要在某个细分领域足够准,能解决具体问题,就能活下去赚钱。比如给煤矿整理安全巡检记录的,给医院整理门诊病历的,给装修公司自动生成报价单的,这些场景不需要大模型懂怎么写诗,只要把一件事做好,就够了。第三,大语言模型会变成水电一样的基础设施。三五年之后,没人会天天把“大语言模型”挂在嘴边吹了,它会藏在你用的每一个软件背后:你写邮件它帮你顺一遍逻辑,你做报表它帮你整理异常数据,你做设计它帮你出素材草稿,就像你现在用电一样,你不会天天说你在用电力,你只会用它安安稳稳干活。
前阵子跟一个大厂的AI实验室负责人吃饭,他说一句话我印象特别深:当年互联网出来的时候,所有人都喊着颠覆一切,结果呢,真的改变了世界,但不是一夜之间变的,是用了二十年一点点渗进去的。大语言模型也一样。现在泡沫挤得差不多了,正好停下来,找找真问题,做做真事情。 
