联邦学习:数据隐私铁门之后,AI的另一条工业化道路
上个月跟一位城商行的风控负责人吃饭,酒过三巡他开始吐槽。之前攒了两年的跨机构客户数据,本来想训个更准的反欺诈模型,刚要启动就被合规打回来了。现在谁敢碰跨机构原始数据流转?碰了就是顶格处罚。
他说,现在全行业都卡在这:AI需要更多数据才能更准,可数据不能随便流动,更不能聚在一起,这死结怎么解?
很多人给他指了路:试试联邦学习。
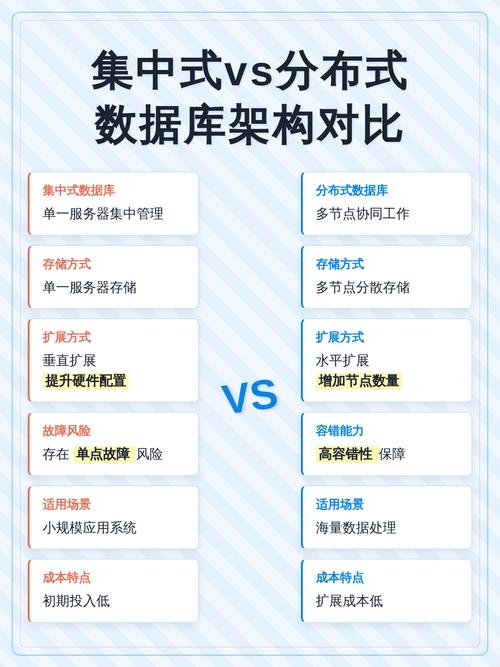 联邦学习集中式 vs 分布式训练对比图
很多人吹它是隐私计算的终极答案,不对。它从出生起,就是为了解决「数据孤岛+合规要求」这一对具体的矛盾,不是什么包治百病的神药。
它的技术边界也很清晰:只解决数据不出域前提下的协同建模问题。要是你的数据能合法合规集中存储训练,联邦学习反而更麻烦,成本更高,没人会用它。就是现在数据管得严了,原来的路子走不通了,才轮到它上台。
说实话,这个思路真的很务实。相当于大家一起攒了个AI,每家出自己的数据原料,但原料都不离开自己家,只把做好的零件拿出来拼,最后成品大家一起用,谁都没亏谁,也没碰规则红线。
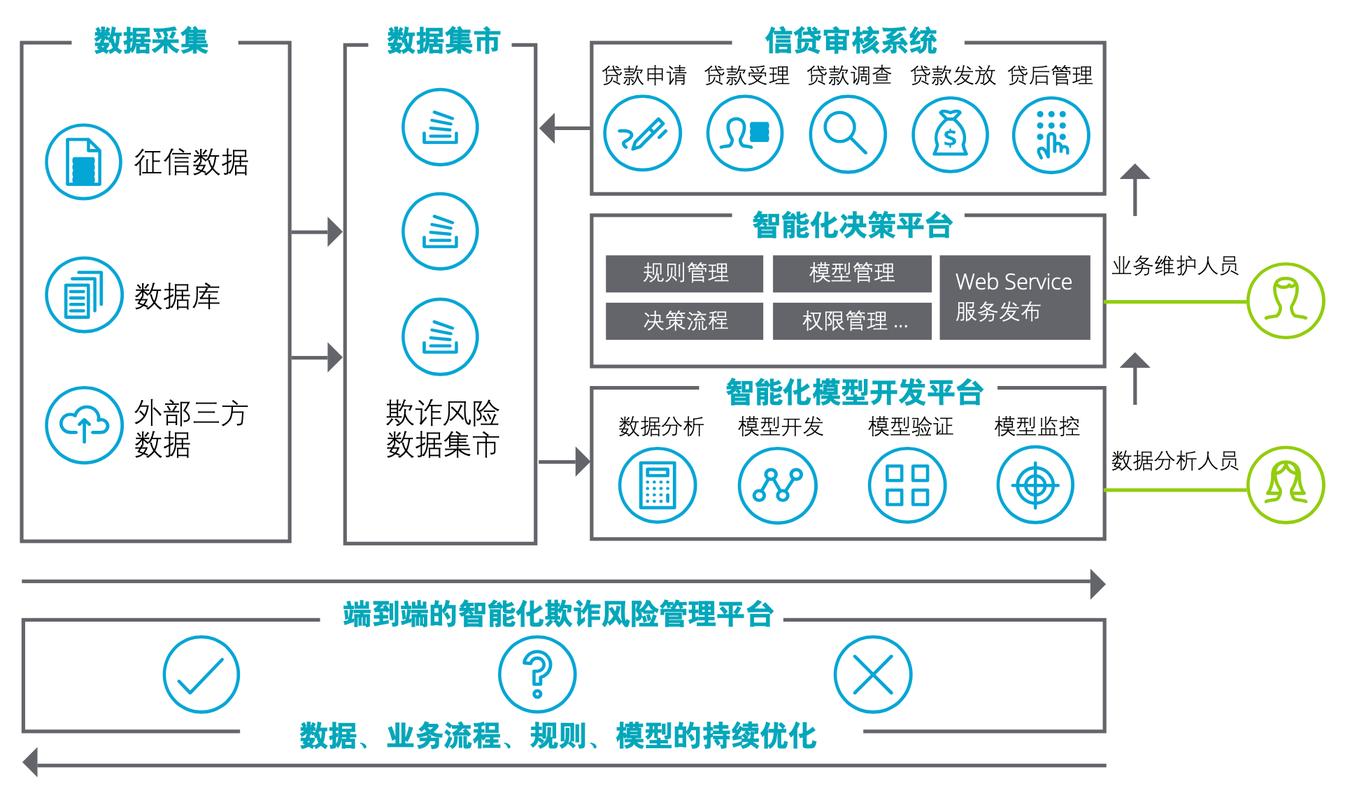 金融行业联邦学习反欺诈应用架构图
不过话说回来,现在整个产业还在半坡上,远没到大规模普及的时候。痛点非常明确。
第一个痛点是成本。参与训练的节点越多,需要传输的参数就越多,通信成本比集中式训练高好几倍,要是训个大模型,那带宽成本能吓死人。现在也就金融这种对精度提升敏感、能承担成本的行业玩得起,普通中小企业根本掏不起这个钱。
第二个痛点是安全不是百分百。很多人以为只要不传原始数据就安全,其实不对。现在已经有技术能从传输的梯度参数里,反推出部分原始用户信息,只是攻击门槛比较高而已。这个漏洞怎么补?现在还没有统一的行业解决方案,各家都在自己打补丁。
第三个痛点是异构数据太难对齐。现在落地的大多是同构联邦,就是大家的数据类型、格式差不多,对齐起来容易。真要跨行业,比如银行和零售企业联合建模,两边的数据维度差十万八千里,对齐成本高到离谱,能做成的案例没几个。
现在整个市场的玩家也分层:互联网大厂自己有场景,自己闷头做技术内部用;云厂商把联邦学习做成SaaS服务卖给大机构;还有一批早期创业公司,主打联邦学习全栈解决方案,现在大多扎根在政务、金融这些大客户领域。
 未来三年,联邦学习会变成AI刚需吗?
现在监管对数据流通的态度越来越严,AI对数据的需求越来越大,这一对矛盾只会越来越突出,联邦学习的刚需性只会越来越强。
我判断未来三年,首先会在三个领域快速落地:第一个是持牌金融机构的联合建模,这个需求已经验证了,接下来就是从大银行往中小机构渗透;第二个是政务数据的开放利用,政务数据不能随便出域,又要给企业用,联邦学习正好匹配这个场景;第三个就是大模型的联合训练,现在各家都缺高质量数据,又不想把自己的数据交出去,几家机构联合训行业大模型,每家数据都不出域,正好对路,现在已经有团队在试点了。
但风险和治理问题也不能回避。第一个就是责任划分,联邦学习的模型是多家一起训的,要是模型输出出了问题,比如给用户错判了风控等级,责任算谁的?是提供数据的机构,还是做模型的机构?现在全行业还没捋清楚这个规则。第二个就是隐私安全的统一测评,现在谁家都说自己的联邦学习安全,到底安不安全,没有统一的第三方测评标准,客户选的时候全靠猜。
别指望联邦学习取代传统的集中式AI训练。刚才说了,要是数据能合法聚在一起,集中训练的精度更高、成本更低,没人会选联邦。它就是现有体系下的一个补充,是给那些数据不能流通的场景,量身做的一条路。
之前资本炒概念的时候,把它吹得天花乱坠,说要重构整个数据产业,现在潮水退了,大家反而冷静了。联邦学习不是什么革命性的颠覆技术,它就是给当前数据行业的死结,找了一个务实的解法。
接下来三年,能不能把通信成本降下来,把安全标准建起来,把责任规则理清楚,决定了它能走多远。至少现在看,方向没错,剩下的就是慢慢磨了。
什么是联邦学习?不是噱头,是被逼出来的技术路线
说穿了逻辑很简单。传统AI训练,是数据凑到模型这边来,把所有原始数据汇集到一个中心节点,训完再产出模型。 联邦学习反过来,是模型走到数据那边去。每家机构把自己的数据存在本地,不出自己的机房,只需要把训练过程中更新的模型参数传出来,各方同步参数,最后得到一个大家共同训好的模型。整个过程,没人能拿到别人的原始数据。联邦学习集中式 vs 分布式训练对比图
很多人吹它是隐私计算的终极答案,不对。它从出生起,就是为了解决「数据孤岛+合规要求」这一对具体的矛盾,不是什么包治百病的神药。
它的技术边界也很清晰:只解决数据不出域前提下的协同建模问题。要是你的数据能合法合规集中存储训练,联邦学习反而更麻烦,成本更高,没人会用它。就是现在数据管得严了,原来的路子走不通了,才轮到它上台。
说实话,这个思路真的很务实。相当于大家一起攒了个AI,每家出自己的数据原料,但原料都不离开自己家,只把做好的零件拿出来拼,最后成品大家一起用,谁都没亏谁,也没碰规则红线。
产业化走到哪了?落地半坡,痛点很明确
现在联邦学习走得最快的场景,全都是数据敏感度最高、合规要求最严的领域。 首当其冲就是金融。国内至少十几家股份制银行和城商行,已经把联邦学习用在跨机构反欺诈、联合风控上了。两家银行共享不了客户原始数据,但用联邦学习训出来的模型,坏账识别率比单家训练能提十几个点,这个收益足够覆盖技术投入了。 其次是互联网广告。媒体有用户行为数据,广告主有转化数据,两边都不能把原始数据给对方,用联邦学习做点击率预估,模型精度比原来的方法高不少,已经有头部平台在规模化用了。医疗领域也在试,不同医院的病例数据不能流通,联合训癌症预测模型,也有不错的试点结果。金融行业联邦学习反欺诈应用架构图
不过话说回来,现在整个产业还在半坡上,远没到大规模普及的时候。痛点非常明确。
第一个痛点是成本。参与训练的节点越多,需要传输的参数就越多,通信成本比集中式训练高好几倍,要是训个大模型,那带宽成本能吓死人。现在也就金融这种对精度提升敏感、能承担成本的行业玩得起,普通中小企业根本掏不起这个钱。
第二个痛点是安全不是百分百。很多人以为只要不传原始数据就安全,其实不对。现在已经有技术能从传输的梯度参数里,反推出部分原始用户信息,只是攻击门槛比较高而已。这个漏洞怎么补?现在还没有统一的行业解决方案,各家都在自己打补丁。
第三个痛点是异构数据太难对齐。现在落地的大多是同构联邦,就是大家的数据类型、格式差不多,对齐起来容易。真要跨行业,比如银行和零售企业联合建模,两边的数据维度差十万八千里,对齐成本高到离谱,能做成的案例没几个。
现在整个市场的玩家也分层:互联网大厂自己有场景,自己闷头做技术内部用;云厂商把联邦学习做成SaaS服务卖给大机构;还有一批早期创业公司,主打联邦学习全栈解决方案,现在大多扎根在政务、金融这些大客户领域。
未来三年,联邦学习会变成AI刚需吗?
未来三年,联邦学习会变成AI刚需吗?
现在监管对数据流通的态度越来越严,AI对数据的需求越来越大,这一对矛盾只会越来越突出,联邦学习的刚需性只会越来越强。
我判断未来三年,首先会在三个领域快速落地:第一个是持牌金融机构的联合建模,这个需求已经验证了,接下来就是从大银行往中小机构渗透;第二个是政务数据的开放利用,政务数据不能随便出域,又要给企业用,联邦学习正好匹配这个场景;第三个就是大模型的联合训练,现在各家都缺高质量数据,又不想把自己的数据交出去,几家机构联合训行业大模型,每家数据都不出域,正好对路,现在已经有团队在试点了。
但风险和治理问题也不能回避。第一个就是责任划分,联邦学习的模型是多家一起训的,要是模型输出出了问题,比如给用户错判了风控等级,责任算谁的?是提供数据的机构,还是做模型的机构?现在全行业还没捋清楚这个规则。第二个就是隐私安全的统一测评,现在谁家都说自己的联邦学习安全,到底安不安全,没有统一的第三方测评标准,客户选的时候全靠猜。
别指望联邦学习取代传统的集中式AI训练。刚才说了,要是数据能合法聚在一起,集中训练的精度更高、成本更低,没人会选联邦。它就是现有体系下的一个补充,是给那些数据不能流通的场景,量身做的一条路。
之前资本炒概念的时候,把它吹得天花乱坠,说要重构整个数据产业,现在潮水退了,大家反而冷静了。联邦学习不是什么革命性的颠覆技术,它就是给当前数据行业的死结,找了一个务实的解法。
接下来三年,能不能把通信成本降下来,把安全标准建起来,把责任规则理清楚,决定了它能走多远。至少现在看,方向没错,剩下的就是慢慢磨了。 
