多模态大模型:捅破AI落地真实世界的那层窗户纸
上个月跟做连锁餐饮的老陈喝茶,他吐了一个钟头的苦。花十几万上线的AI客服,能聊优惠能排号,一碰到客人发张厨房地沟的照片、传个投诉的语音,直接傻掉,还是得转人工,等于钱扔水里响都没响。
这不只是老陈一个人的麻烦。这两年大模型火了一圈,落地卡在哪?卡在单模态只能看文字,碰上个真实世界的杂乱信息就抓瞎。多模态大模型,就是来捅破这层窗户纸的。
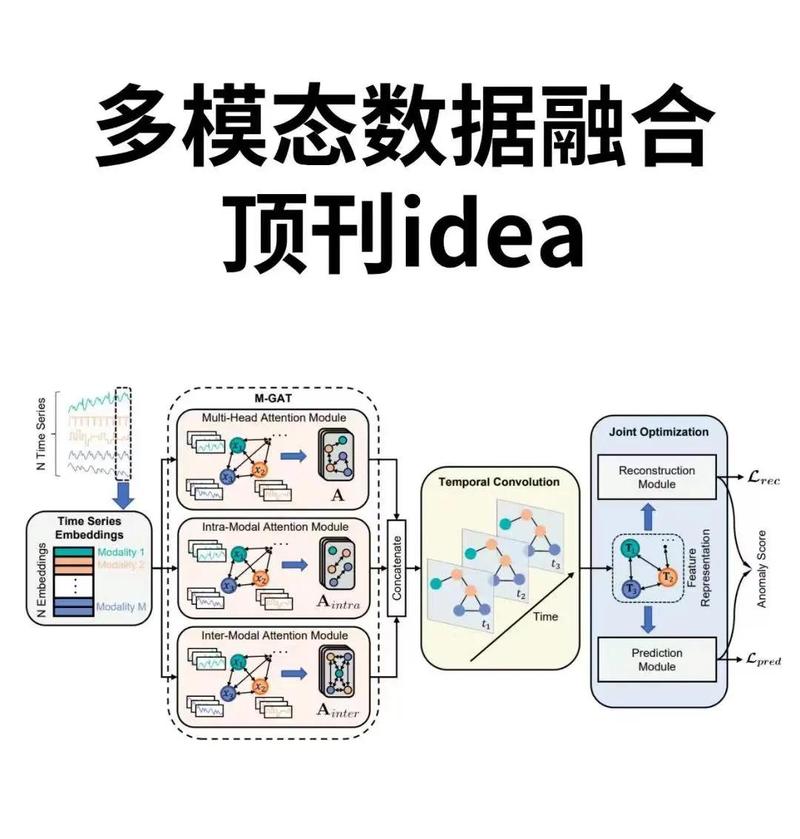 多模态大模型跨模态融合架构示意图
但也别说得太神。现在大部分商用的多模态,还是拼接式多模态,真的从底层就完全融合的原生多模态,还在实验室阶段。瓶颈明摆着:第一是标注数据不够,跨模态标注要比纯文本标注贵十倍以上,还要对应不同场景做细分标注,小公司根本拿不出这个钱。第二是推理成本高,同样一轮交互,多模态消耗的算力是纯文本的2到3倍,想大规模落地,成本还压不下来。
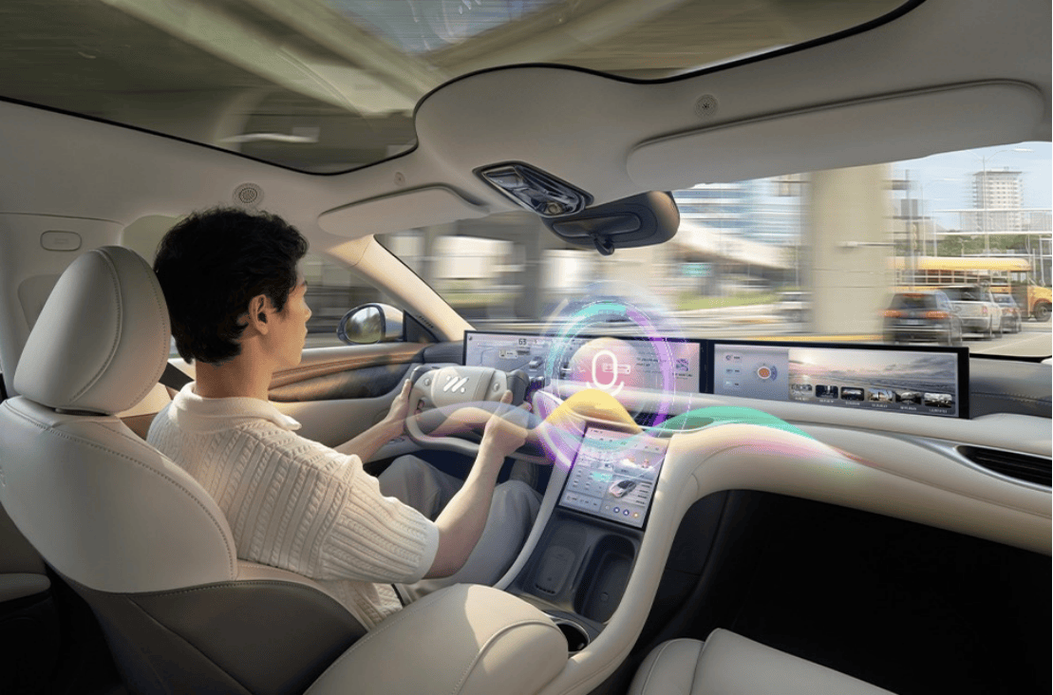 新能源汽车座舱多模态大模型交互场景图
不过话说回来,落地的障碍还是比你想的多。第一是数据安全,很多制造业的图纸、医疗的影像,都是涉密或者隐私数据,不敢放到公有云的多模态大模型上去跑,私有化部署的成本又太高,中小企业扛不住。第二是版权问题,多模态训练要用大量的图文音视频数据,现在大部分数据都是公开爬取的,没给原作者版权费,这个账早晚要算,说不定哪天就出来几个影响行业的大官司。第三就是造假风险,多模态能直接生成以假乱真的图文结合的假证据、假新闻,比之前单模态的文字造假危害大太多,现在监管规则还没跟上,属于裸奔状态。
 未来3到5年,产业格局会怎么变?
我跟不少投资人和产业一线的人聊过,大部分人都认同一个判断:多模态不是一个锦上添花的新功能,是AI从“实验室炫技”到“落地真实世界”的必经台阶。
3年之内,你能买到的新手机、新智能屏、新车,基本都会把多模态能力做成标配,原来要你点半天操作的事,拍个图说句话就搞定了,普通人不用懂什么是大模型,就能直接感受到变化。To B这边,垂直赛道的多模态大模型会比通用多模态先跑出来。比如专门做医疗影像+电子病历的多模态,专门做工业质检的多模态,只要扎进一个细分赛道,把数据磨顺了,成本压下来,就能抢到大块的市场,不一定打得过巨头的通用大模型,但活的会很舒服。
5年之内,专门针对多模态推理优化的专用芯片会大规模上市,现在推理成本高的问题,会得到根本性缓解,中小公司也能用得起多模态了。当然,风险也摆在那,治理跟不上的话,造假、隐私、版权这些问题,说不定会出来黑天鹅,把整个行业的节奏拖慢。
说实话,很多人现在吹多模态是AGI的起点,我觉得太夸张了。它就是AI发展的一个必经阶段,解决了AI能不能看懂真实世界的问题。但就这一个问题的解决,足够把现在的AI产业格局重新洗一遍。原来做单模态AI的厂商,要是还抱着原来的一亩三分地不撒手,再过三四年,估计连饭都吃不上了。
对吧?
多模态到底解决了什么核心问题?
AI发展这么多年,过去大部分模型都是“专科生”,看文本的就只看文本,认图像的就只认图像,各干各的。多模态大模型是能跨领域理解的“通才”,可以同时处理文本、图像、音频、视频甚至3D点云这些完全不同类型的信息,还能把它们打通了做推理、生成内容。 很多人以为多模态就是把图像识别加语言模型拼一块,这是典型的误会。现在主流的商用多模态,已经做到了统一语义空间映射,就是不管你是拍张猫的照片,还是打出“猫”这个字,模型都能把它转换成同一个语义下的向量,真的能对应上同一个概念,不是硬凑的。多模态大模型跨模态融合架构示意图
但也别说得太神。现在大部分商用的多模态,还是拼接式多模态,真的从底层就完全融合的原生多模态,还在实验室阶段。瓶颈明摆着:第一是标注数据不够,跨模态标注要比纯文本标注贵十倍以上,还要对应不同场景做细分标注,小公司根本拿不出这个钱。第二是推理成本高,同样一轮交互,多模态消耗的算力是纯文本的2到3倍,想大规模落地,成本还压不下来。
产业落地:已经藏在你看不见的地方
别以为多模态还停留在大厂的PPT里,其实不少场景已经用起来了。我上个月跑长三角的制造业,看到一家做汽车零配件的工厂,已经用多模态大模型做探伤质检了。 原来的流程是,X光拍了零件裂纹,要AI识别的话,得专门标注几万张裂纹图,还要用规范文字写好判定标准,模型改来改去要三个月,碰到新的裂纹类型还要重新训练。现在呢?工人把X光图导进去,直接用大白话跟模型说“找长度超过2毫米的横向裂纹,把对应的零件编号标出来,不合格的直接列成表格”,不到一周就跑起来了,质检效率比原来提了三倍,错检漏检还少了近两成。 还有智能座舱,现在新出的几款主流新能源车企的顶配车型,已经用上了多模态交互。你拍一下窗外的山,跟车机说“把这个景设成中控壁纸,调暗一点别晃眼睛”,不用分两步操作,直接一次搞定,体验比原来只能说指令的单模态车机顺太多。新能源汽车座舱多模态大模型交互场景图
不过话说回来,落地的障碍还是比你想的多。第一是数据安全,很多制造业的图纸、医疗的影像,都是涉密或者隐私数据,不敢放到公有云的多模态大模型上去跑,私有化部署的成本又太高,中小企业扛不住。第二是版权问题,多模态训练要用大量的图文音视频数据,现在大部分数据都是公开爬取的,没给原作者版权费,这个账早晚要算,说不定哪天就出来几个影响行业的大官司。第三就是造假风险,多模态能直接生成以假乱真的图文结合的假证据、假新闻,比之前单模态的文字造假危害大太多,现在监管规则还没跟上,属于裸奔状态。
未来3到5年,产业格局会怎么变?
未来3到5年,产业格局会怎么变?
我跟不少投资人和产业一线的人聊过,大部分人都认同一个判断:多模态不是一个锦上添花的新功能,是AI从“实验室炫技”到“落地真实世界”的必经台阶。
3年之内,你能买到的新手机、新智能屏、新车,基本都会把多模态能力做成标配,原来要你点半天操作的事,拍个图说句话就搞定了,普通人不用懂什么是大模型,就能直接感受到变化。To B这边,垂直赛道的多模态大模型会比通用多模态先跑出来。比如专门做医疗影像+电子病历的多模态,专门做工业质检的多模态,只要扎进一个细分赛道,把数据磨顺了,成本压下来,就能抢到大块的市场,不一定打得过巨头的通用大模型,但活的会很舒服。
5年之内,专门针对多模态推理优化的专用芯片会大规模上市,现在推理成本高的问题,会得到根本性缓解,中小公司也能用得起多模态了。当然,风险也摆在那,治理跟不上的话,造假、隐私、版权这些问题,说不定会出来黑天鹅,把整个行业的节奏拖慢。
说实话,很多人现在吹多模态是AGI的起点,我觉得太夸张了。它就是AI发展的一个必经阶段,解决了AI能不能看懂真实世界的问题。但就这一个问题的解决,足够把现在的AI产业格局重新洗一遍。原来做单模态AI的厂商,要是还抱着原来的一亩三分地不撒手,再过三四年,估计连饭都吃不上了。
对吧? 
