自然语言处理:从听懂人话到改变产业,我们走到哪一步了
去年跟一个做企业服务的老朋友喝酒。他吐槽。现在随便见个客户,开口第一句必问:你们家产品带自然语言处理能力不?哪怕他原本只是卖考勤系统的。
离谱。所有人都在说自然语言处理,所有人都想蹭这波热度,可大部分人根本说不清楚,这东西到底能做什么,不能做什么。
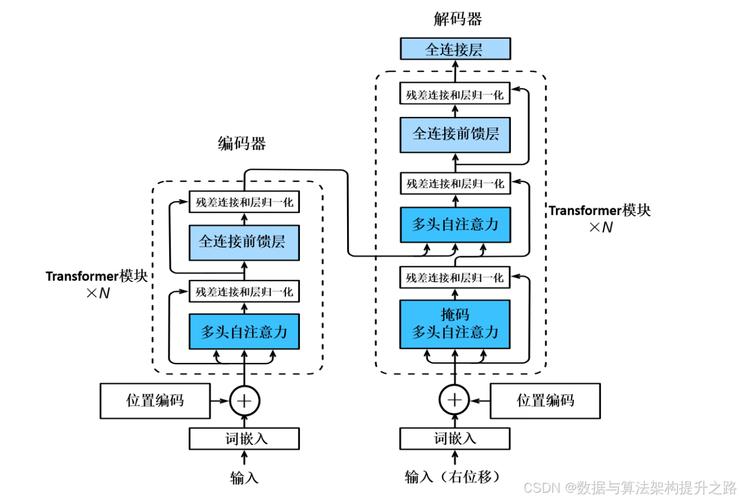 大模型自然语言处理编码解码流程图
你让它写一篇四平八稳的公关稿,它做得比很多刚入行的实习生还好。你跟它说“我感觉不太舒服,你帮我看看我要不要去医院”,它能给你列一堆可能性,可它读不懂你说这句话时候的恐慌,也分不清你说的“不太舒服”是工作太累还是真的脏器出了问题。
现在行业里最大的泡沫,就是把自然语言处理吹成了无所不能的神器。套个大模型壳子就敢说自己是国内顶尖服务商,转头接了单还得去调用第三方接口赚差价。真遇到需要落地的场景,掉链子是常事。
自然语言处理现在的天花板非常清晰:处理标准化、有明确规则的文本语音,效率碾压人类。处理模糊的、带潜规则的、充满上下文跳跃的人类真实表达,还差得远。
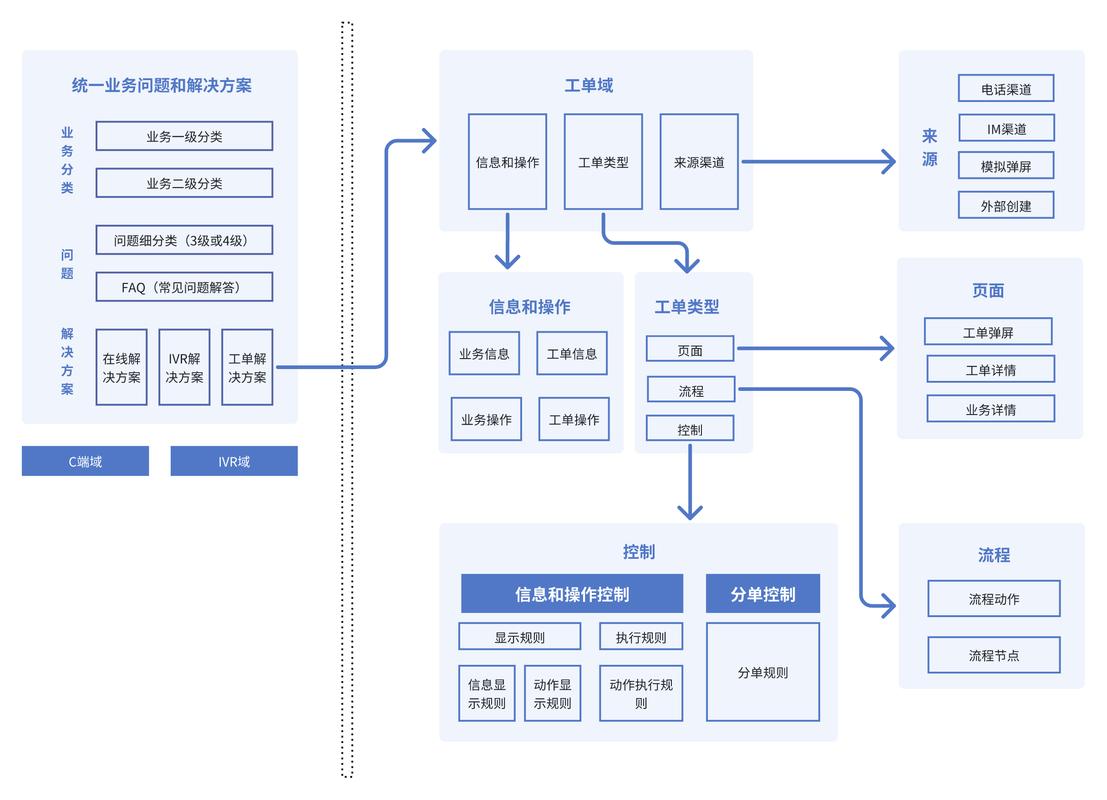 企业级自然语言处理工单分类场景示意图
金融机构需要用自然语言处理做舆情监控,一天几十万条社交媒体、研报、新闻,机器一秒就能分类打上标签,告诉你哪家上市公司最近负面情绪涨了三倍,哪个板块的讨论度突然起来了。放在十年前,这得养一个几十人的舆情团队天天刷手机。
top律所都在用自然语言处理做类案检索。几百万份过往判决书、起诉书,找相同案由的判例,原来一个资深律师得翻三天,现在输入关键词,半小时就能整理好完整的判例报告,法官的裁判倾向都给你标出来。
还有制造业的售后工单,用户打电话过来投诉,自然语言处理直接就能把语音转文字,自动分类是产品质量问题还是安装问题,派给对应部门,根本不需要人工再抄一遍登记。
不过话说回来,落地的坑也真的多。第一个坑就是高质量标注数据太贵。好的标注数据,一块钱一条都拿不下来,养一个标注团队一年成本几百万,中小创业公司根本扛不住。数据质量差,训练出来的模型准确率上不去,接不到单,死循环。
第二个坑是定制化成本太高。给金融做的模型,不能直接拿去给医疗用,哪怕核心架构一样,行业术语、语境全不一样,改一遍就是几十万上百万。很多中小制造企业想用自然语言处理降本,一算成本,得三五年才能收回来,干脆不用了。
现在活的好的自然语言处理公司,几乎都是扎进一个垂直赛道死磕。比如就做医疗病历处理,就做法律文书,磨个两三年,把模型准确率磨上去,把行业规则摸透,反而能拿到稳定的订单。那些喊着做通用大模型的小公司,死了一大片了。
 躲不开的暗坑,没人愿意提前说的风险
自然语言处理发展太快,监管和行业规则远远跟不上,很多风险已经冒头了。
最常见的就是版权问题。现在大部分自然语言生成模型,训练数据都是爬的网上公开内容,很多是有版权的,写出来的东西,一不小心就抄了原作者的表达,打官司都找不到责任人算谁的。
然后就是黑产滥用。现在自然语言处理做语音克隆,只要给你十秒钟录音,就能一模一样复制你的声音,诈骗分子已经用这个骗了好多人了。去年我身边就有朋友的亲戚,被克隆老板声音骗走了两百万,追都追不回来。还有批量生成诈骗话术、钓鱼短信,原来一个诈骗团伙一天发一万条,现在一天能发一百万条,防不胜防。
还有算法偏见的问题。训练数据里本来就藏着人类的偏见,自然语言处理模型会把这个偏见放大。之前就出过事,某公司用自然语言处理模型筛简历,模型自动给女性求职者打更低的分,因为过去十年招的高管大部分是男性,模型就学歪了。这种偏见你不说,根本没人知道模型内部是怎么判断的。
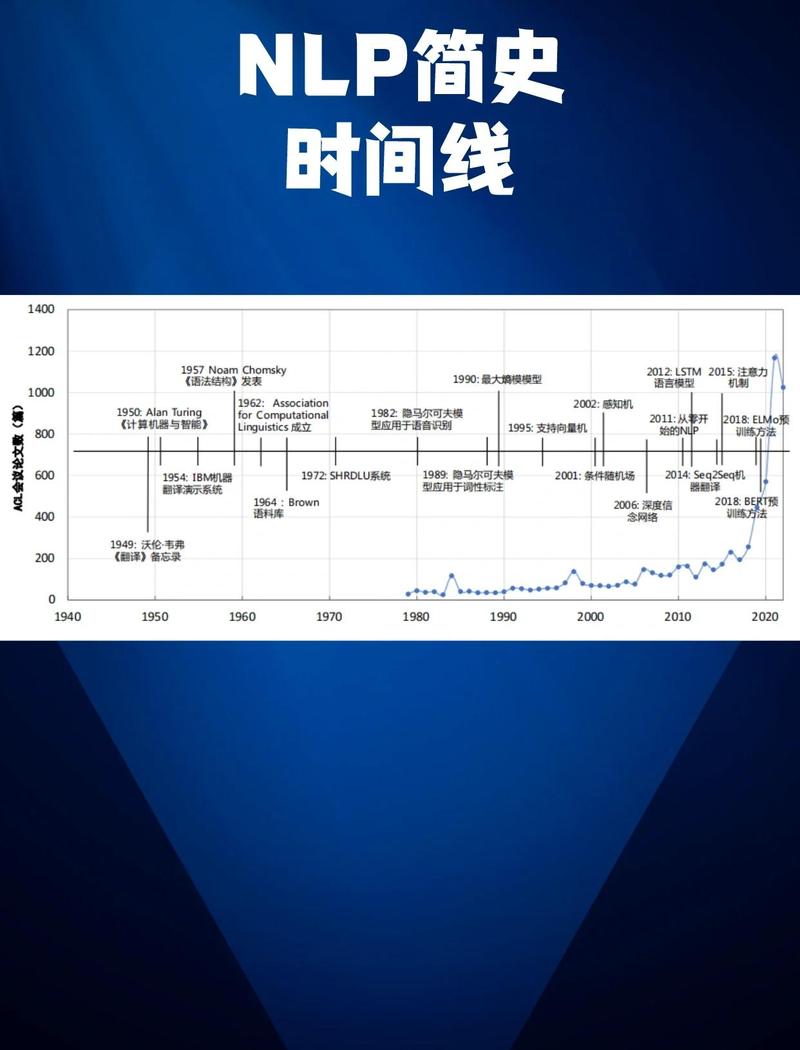 未来三五年,自然语言处理会变成什么样子
我跟几个产业资本的朋友聊过,大家的判断差不多。
首先,通用自然语言处理的讲故事时代过去了,接下来资本只会投垂直落地的项目。泡泡挤干净了,剩下的都是真干活的。
然后,自然语言处理会变成水电煤一样的基础设施。不会再有很多公司自己搭模型训练,大部分公司都是买云厂商的API,按调用量付钱,成本会降得很低,中小企业也能用得起。
接下来,监管肯定会跟上。用自然语言处理生成内容,不管是文章还是语音视频,必须强制标注是AI生成的。语音克隆这类技术,肯定会要求实名认证,不能随便用。
最后,不用担心自然语言处理会抢了大部分文字工作者的饭碗。它会抢走那些重复的、低价值的工作,比如整理资料、写初稿,但是真正需要创意、需要懂人性、懂潜规则的工作,还是得人来。就像当年打字机发明的时候,大家说书记员会失业,结果书记员变成了更高级的文字工作者。
技术永远是工具。哪有什么神奇的魔法,不过是帮人类把脏活累活干了,让人去做更值钱的事罢了。
被高估的全能,被低估的技术边界
很多人以为,现在大模型火了,自然语言处理已经让机器真的“听懂”人话了。 说实话,哪有那么玄。自然语言处理从诞生到现在,核心逻辑从来没变过:让机器把人类的语言转换成可计算的向量,再通过训练好的模型,输出符合人类预期的结果。它从来不是真的理解语言背后的情绪、潜台词甚至文化语境,只是在概率层面找到最匹配的答案。大模型自然语言处理编码解码流程图
你让它写一篇四平八稳的公关稿,它做得比很多刚入行的实习生还好。你跟它说“我感觉不太舒服,你帮我看看我要不要去医院”,它能给你列一堆可能性,可它读不懂你说这句话时候的恐慌,也分不清你说的“不太舒服”是工作太累还是真的脏器出了问题。
现在行业里最大的泡沫,就是把自然语言处理吹成了无所不能的神器。套个大模型壳子就敢说自己是国内顶尖服务商,转头接了单还得去调用第三方接口赚差价。真遇到需要落地的场景,掉链子是常事。
自然语言处理现在的天花板非常清晰:处理标准化、有明确规则的文本语音,效率碾压人类。处理模糊的、带潜规则的、充满上下文跳跃的人类真实表达,还差得远。
产业化落地:真正赚钱的都不在C端讲故事
C端的聊天机器人、AI文案写手可太火了,吸引了所有眼球。可你去打听打听,整个自然语言处理产业里,真正稳定赚钱的项目,几乎都在B端。企业级自然语言处理工单分类场景示意图
金融机构需要用自然语言处理做舆情监控,一天几十万条社交媒体、研报、新闻,机器一秒就能分类打上标签,告诉你哪家上市公司最近负面情绪涨了三倍,哪个板块的讨论度突然起来了。放在十年前,这得养一个几十人的舆情团队天天刷手机。
top律所都在用自然语言处理做类案检索。几百万份过往判决书、起诉书,找相同案由的判例,原来一个资深律师得翻三天,现在输入关键词,半小时就能整理好完整的判例报告,法官的裁判倾向都给你标出来。
还有制造业的售后工单,用户打电话过来投诉,自然语言处理直接就能把语音转文字,自动分类是产品质量问题还是安装问题,派给对应部门,根本不需要人工再抄一遍登记。
不过话说回来,落地的坑也真的多。第一个坑就是高质量标注数据太贵。好的标注数据,一块钱一条都拿不下来,养一个标注团队一年成本几百万,中小创业公司根本扛不住。数据质量差,训练出来的模型准确率上不去,接不到单,死循环。
第二个坑是定制化成本太高。给金融做的模型,不能直接拿去给医疗用,哪怕核心架构一样,行业术语、语境全不一样,改一遍就是几十万上百万。很多中小制造企业想用自然语言处理降本,一算成本,得三五年才能收回来,干脆不用了。
现在活的好的自然语言处理公司,几乎都是扎进一个垂直赛道死磕。比如就做医疗病历处理,就做法律文书,磨个两三年,把模型准确率磨上去,把行业规则摸透,反而能拿到稳定的订单。那些喊着做通用大模型的小公司,死了一大片了。
躲不开的暗坑,没人愿意提前说的风险
躲不开的暗坑,没人愿意提前说的风险
自然语言处理发展太快,监管和行业规则远远跟不上,很多风险已经冒头了。
最常见的就是版权问题。现在大部分自然语言生成模型,训练数据都是爬的网上公开内容,很多是有版权的,写出来的东西,一不小心就抄了原作者的表达,打官司都找不到责任人算谁的。
然后就是黑产滥用。现在自然语言处理做语音克隆,只要给你十秒钟录音,就能一模一样复制你的声音,诈骗分子已经用这个骗了好多人了。去年我身边就有朋友的亲戚,被克隆老板声音骗走了两百万,追都追不回来。还有批量生成诈骗话术、钓鱼短信,原来一个诈骗团伙一天发一万条,现在一天能发一百万条,防不胜防。
还有算法偏见的问题。训练数据里本来就藏着人类的偏见,自然语言处理模型会把这个偏见放大。之前就出过事,某公司用自然语言处理模型筛简历,模型自动给女性求职者打更低的分,因为过去十年招的高管大部分是男性,模型就学歪了。这种偏见你不说,根本没人知道模型内部是怎么判断的。
未来三五年,自然语言处理会变成什么样子
未来三五年,自然语言处理会变成什么样子
我跟几个产业资本的朋友聊过,大家的判断差不多。
首先,通用自然语言处理的讲故事时代过去了,接下来资本只会投垂直落地的项目。泡泡挤干净了,剩下的都是真干活的。
然后,自然语言处理会变成水电煤一样的基础设施。不会再有很多公司自己搭模型训练,大部分公司都是买云厂商的API,按调用量付钱,成本会降得很低,中小企业也能用得起。
接下来,监管肯定会跟上。用自然语言处理生成内容,不管是文章还是语音视频,必须强制标注是AI生成的。语音克隆这类技术,肯定会要求实名认证,不能随便用。
最后,不用担心自然语言处理会抢了大部分文字工作者的饭碗。它会抢走那些重复的、低价值的工作,比如整理资料、写初稿,但是真正需要创意、需要懂人性、懂潜规则的工作,还是得人来。就像当年打字机发明的时候,大家说书记员会失业,结果书记员变成了更高级的文字工作者。
技术永远是工具。哪有什么神奇的魔法,不过是帮人类把脏活累活干了,让人去做更值钱的事罢了。 
