多模态大模型:产业落地的真革命,还是泡沫续集?
别被概念筐住:多模态大模型的核心变在哪
早十年就有AI能识别图片内容,早五年也有模型能给视频打标签。那些都是多模态吗?严格说不算。
以前的所谓多模态,就是把不同模态的训练结果简单拼接。你给一张图,模型先识别出“猫”“沙发”两个标签,再把标签喂给文本模型生成描述。说白了就是两个单模态模型搭了个桥。
现在的新一代多模态大模型,核心是统一语义空间对齐。
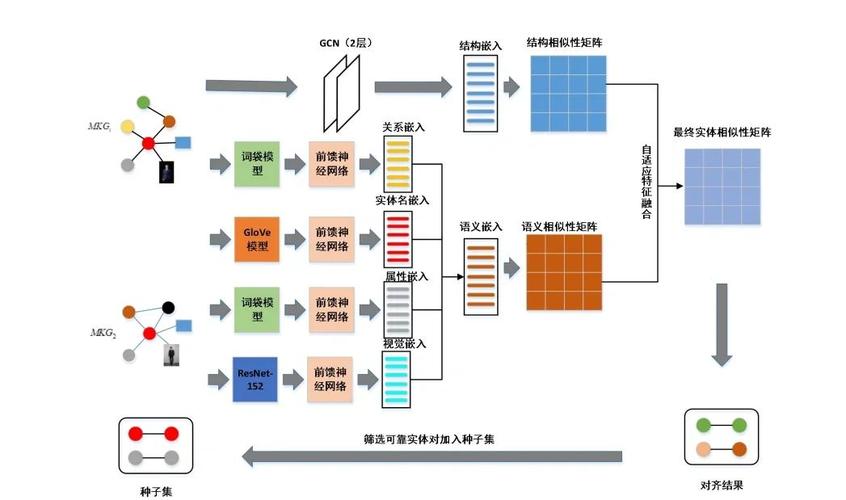 多模态大模型统一语义对齐原理图
就是文字、图片、音频、视频所有类型的信息,都会被映射到同一个语义空间里。模型看到的不是“图片的像素”和“文字的编码”,而是“一张放在沙发上的橘猫,它的毛是姜黄色,尾巴搭在爪子上”这个完整的语义。不用转标签,直接理解。
这个变化才是本质。但技术边界也很清晰。现在没有任何一个多模态大模型能做到真正的“全模态理解”。你拿一张模糊的手绘工程图给它,让它算出受力参数,它多半会瞎编。它能懂浅层语义,复杂专业场景的深层关联,还是搞不定。
第一批落地者:哪些赛道已经跑通了小循环
说实话,我见过太多创业公司拿着多模态的概念融钱,转头连个可用的场景都找不到。但真的落地案例,已经有了。
第一个就是内容生产行业。现在中小广告公司做海报,设计师出完文案,直接喂给多模态大模型,就能出十几套不同风格的初稿,还能根据要求改颜色改构图,效率至少提了三倍。互联网公司做UI更夸张,一张手绘草图丢进去,半小时出高保真原型还带前端代码,实习生都能单兵作战做个小程序。
然后是电商和本地生活。现在不少品牌的自播间,已经用上了多模态AI主播。
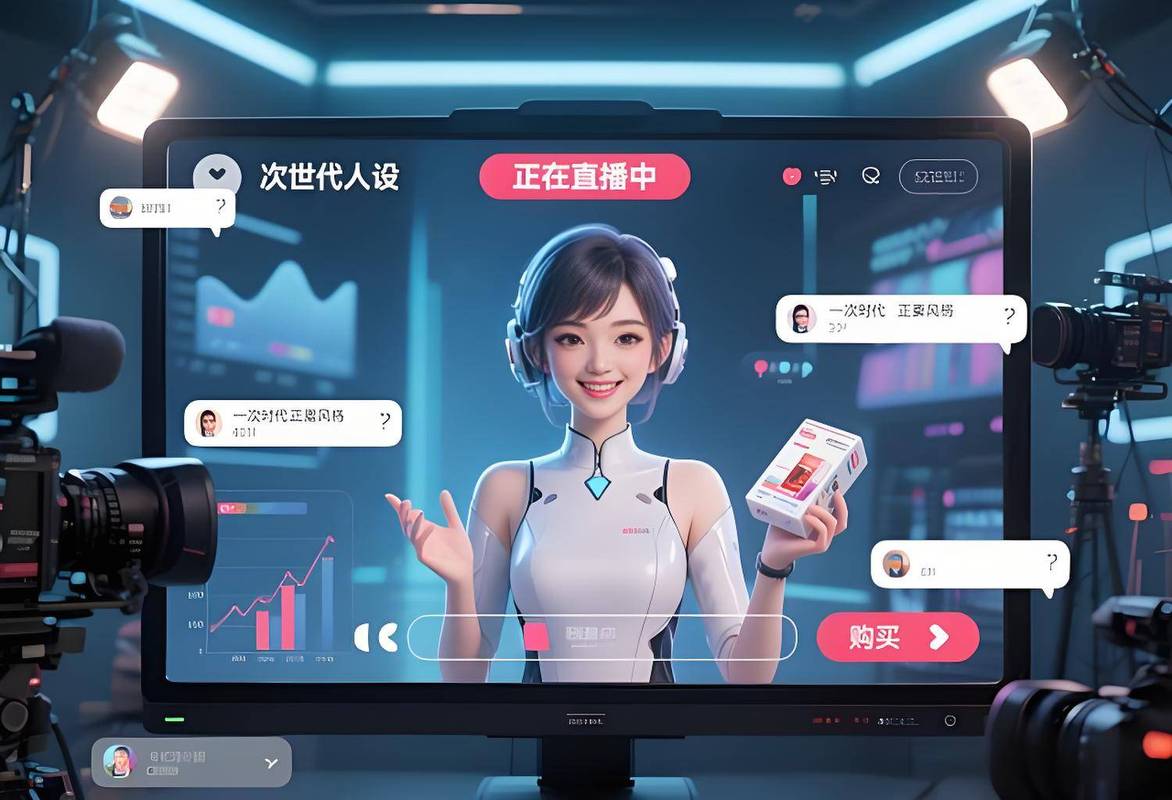 多模态大模型电商AI主播直播场景图
它能实时看懂弹幕里的问题,比如有人问“这件衣服起球吗”,它能对着商品详情图直接找出参数回答,不用提前录好所有台词。还有生活服务平台,现在用多模态审核商家的门头图和资质,准确率比之前的单模态模型高了快二十个点,人工审核的工作量砍了一半。
医疗领域的试点也有了。现在不少三甲医院用多模态模型帮医生读片,把CT影像和病人的过往病历、检查报告放在一起分析,能提示出单靠读片容易漏掉的病灶,当然最后还是医生拍板,但已经能省不少时间。
藏在聚光灯下的坑:我们还要面对什么问题
 藏在聚光灯下的坑:我们还要面对什么问题
第一个坑就是钱。算力成本太吓人了。训一个能用的通用多模态大模型,成本比同参数的文本大模型高三到五倍。推理更贵,你每次发图让模型分析,它要处理的信息量是纯文本的好几倍,现在To B端按调用量收费,很多中小公司根本用不起。
第二个坑是幻觉放大。纯文本大模型会一本正经胡说八道,多模态更夸张。它可能看错图片里的一个数字,然后基于这个错数字编出一整套错误的结论。在医疗、法律、工业这些领域,错一个数字就是天大的问题,这个问题到现在还没有完美的解决方案。
第三个就是治理的问题。多模态把深度伪造的门槛拉到了谷底。以前做一个换脸视频还要专门的技术工具,现在你只要给多模态模型一段文字描述加一张照片,几分钟就能出一段以假乱真的视频,还能配对口型和声音。造谣的成本越来越低,监管的难度越来越大。
不过话说回来,这些问题也不是不能解决。技术迭代的速度比大部分人预想的快。
未来三年,通用多模态大模型的格局会很快定型,头几名会占走大部分市场,剩下的都是垂直领域的细分玩家。真正能赚钱的项目,不会是做另一个通用多模态大模型,而是基于头部大模型的能力,在某个垂直场景把成本降下来,把准确率提上去,解决真实的痛点。
未来五年,多模态会变成AI基础设施的标配,就像现在的云计算一样,你不用自己训模型,直接调用就行。那时候才会真正爆发成千上万的中小创新应用。
泡沫肯定会破。
但真正能落地的东西,会留下来。

